Intrebarea pe care o auzim tot mai des de la cabinete de avocatura, clinici si companii de inginerie suna cam asa: "Pot sa caut prin toate documentele noastre cu ceva de genul ChatGPT, dar fara ca vreun document sa plece din birou?" Raspunsul scurt e da. Raspunsul lung e articolul asta.
Un AI rulat local inseamna un model de limbaj care sta pe un server din camera voastra tehnica, nu in cloud-ul cuiva. Il intrebi in romana, iti raspunde in romana, citeste din documentele companiei si nu trimite nimic pe internet. Nici promptul, nici fisierul, nici raspunsul.
Am adunat aici cifrele publicate de cei care masoara serios, cu sursele lor: ce placa video alegi, cat consuma, cat de repede raspunde, ce software pui peste ea si cat te costa fata de un abonament la un AI public. Cifrele sunt din noiembrie 2026. Preturile la placi video s-au miscat mult in ultimul an, asa ca verifica-le din nou cand ajungi la oferta.
Cand nu are sens
Modelele pe care le poti rula local sunt bune, dar nu sunt cele mai bune din lume. Claude, GPT sau Gemini, in variantele lor de top, raman peste ele la rationament complicat, la cod si la texte lungi. Daca vrei cel mai destept asistent posibil si datele tale pot pleca in cloud, un abonament e mai simplu si, la putini utilizatori, mai ieftin.
AI-ul local are sens cand macar una dintre astea e adevarata:
- ai documente care nu au voie sa iasa din companie: dosare medicale, dosare juridice, date financiare, documentatie tehnica sub NDA;
- esti entitate NIS2 sau lucrezi cu clienti care iti cer, prin contract, sa nu trimiti datele lor la terti;
- ai multi utilizatori care ar folosi AI-ul zilnic, iar abonamentele pe utilizator incep sa doara;
- vrei ca asistentul sa raspunda din documentele voastre si sa citeze sursa, nu din ce a invatat de pe internet.
Pentru multe companii raspunsul corect e o combinatie: un AI public, cu reguli clare, pentru treburi generale si unul local pentru documentele sensibile. Despre partea de reguli am scris separat, pe pagina de guvernanta AI.
Placa video decide aproape tot
Un model de limbaj trebuie sa incapa in memoria placii video. Asta e regula de baza si de aici pornesti. Un model de 8 miliarde de parametri, comprimat la 4 biti (cuantizare, cum i se spune), ocupa in jur de 5 GB. Unul de 32 de miliarde ocupa vreo 20 GB. Pe langa model mai ai nevoie de memorie pentru conversatiile in curs, iar cand ai multi utilizatori simultan, partea asta creste repede.
A doua regula: viteza cu care modelul scrie raspunsul depinde mai ales de latimea de banda a memoriei, nu de cate nuclee are placa. De asta un aparat cu multa memorie, dar lenta, poate incarca un model mare si totusi sa raspunda incet.
Trei configuratii care acopera majoritatea cazurilor, fiecare pentru alt tip de companie:
| Configuratie | Memorie | Banda memorie | Consum maxim | Pret orientativ | Pentru cine |
|---|---|---|---|---|---|
| Statie cu NVIDIA RTX 5090 | 32 GB | 1.792 GB/s | 575 W (placa) | 1.999 USD pret de lista la lansare; in magazine, mult peste | 5-20 utilizatori, modele de pana la ~32 miliarde de parametri |
| Server cu NVIDIA RTX PRO 6000 Blackwell | 96 GB | 1.792 GB/s | 600 W (placa) | in UE, in jur de 11.000-13.000 EUR pentru placa (noiembrie 2026) | 20-100+ utilizatori, modele mari de tip gpt-oss-120b |
| NVIDIA DGX Spark (mini-PC) | 128 GB memorie unificata | 273 GB/s | 240 W (tot sistemul) | anuntat la 3.000 USD, livrat in jur de 4.000 USD | pilot, departament mic, teste cu modele mari |
Surse: specificatii si pret RTX 5090 Spheron, pret RTX PRO 6000 in UE GPUPrix, DGX Spark Implicator si forumul NVIDIA.
O observatie despre RTX PRO 6000: a pornit de la aproximativ 8.000 USD si a urcat in 2026 peste 10.000 USD in magazinele americane, din cauza cererii pentru AI si a lipsei de memorie (Digital Citizen). Daca bugetul e strans, o statie cu RTX 5090 e un inceput foarte bun.

Cat de repede raspunde, in cifre
Viteza se masoara in tokeni pe secunda. Un token e cam trei sferturi dintr-un cuvant in engleza, ceva mai putin in romana. Ca reper: un om citeste confortabil in jur de 5-8 tokeni pe secunda. Orice peste 20-30 se simte instant.
| Model | Placa | Viteza de scriere (un utilizator) | Sursa |
|---|---|---|---|
| Qwen3 8B | RTX 5090 | ~200 tokeni/s | Hardware Corner |
| Qwen3 14B | RTX 5090 | ~124 tokeni/s | Hardware Corner |
| Qwen3 32B | RTX 5090 | ~61 tokeni/s | Hardware Corner |
| gpt-oss-20b | RTX 5090 | ~298 tokeni/s | Hardware Corner |
| gpt-oss-120b | RTX PRO 6000 | ~148 tokeni/s | Hardware Corner |
| gpt-oss-120b | DGX Spark | ~60 tokeni/s (scade la ~40 cu context lung) | Spheron |
Cifrele sunt masurate cu llama.cpp, modele cuantizate la 4 biti si context scurt. Cu documente lungi in context, viteza scade.
Dar ce se intampla cand intreaba 30 de oameni deodata. Aici un server de inferenta precum vLLM grupeaza cererile si foloseste placa mult mai eficient. Intr-un test publicat cu 50 de cereri simultane, un RTX PRO 6000 a livrat in total aproximativ 1.780 de tokeni pe secunda cu gpt-oss-120b, iar primul cuvant al raspunsului a aparut in medie dupa 0,34 secunde. Cu modelul mai mic, gpt-oss-20b, totalul a trecut de 4.300 de tokeni pe secunda (Database Mart). Pe scurt: o singura placa buna tine fara probleme un birou intreg.
Cat consuma din priza
Placile de mai sus au limite de 575-600 W, dar nu stau la maxim toata ziua. Un server de inferenta trage mult cat genereaza raspunsuri si putin cat asteapta. DGX Spark are o sursa de 240 W pentru tot sistemul (forumul NVIDIA).
Facem un calcul pentru un server cu RTX PRO 6000. Ipotezele sunt ale noastre, ca sa vezi ordinul de marime: in medie 0,7 kW in cele 10 ore de program, 0,15 kW in rest, 22 de zile lucratoare pe luna. Iese in jur de 230 kWh pe luna. La preturile din ofertele standard pentru companii, intre 1,26 si 2 lei pe kWh in zona Bucuresti-Ilfov (Economedia), curentul costa intre aproximativ 290 si 460 de lei pe luna.
Pe langa curent, conteaza si caldura. Placa scoate aproape toata puterea consumata sub forma de caldura, asa ca serverul are nevoie de o camera aerisita sau climatizata. Intr-un dulap inchis de birou, o placa de 600 W se sufoca.
Cat te costa fata de un abonament
Comparam cu doua abonamente populare, la preturile publicate de producatori:
- Microsoft 365 Copilot Business: 18 USD pe utilizator pe luna, platit anual, pretul afisat in noiembrie 2026 (Microsoft);
- ChatGPT pentru echipe: 25 USD pe utilizator pe luna platit anual, 30 USD lunar (OpenAI).
La 50 de utilizatori, pe trei ani, inseamna 32.400 USD pentru Copilot si 45.000 USD pentru ChatGPT. Placa RTX PRO 6000 costa acum in UE in jur de 11.000-13.000 EUR. Chiar daca dublezi suma pentru restul serverului, pentru instalare si pentru mentenanta, ajungi in aceeasi zona de cost. Cu o diferenta: dupa trei ani serverul e al tau, iar datele n-au plecat niciodata din companie.
La 10 utilizatori calculul se inverseaza. Abonamentul iese mai ieftin, iar AI-ul local se justifica doar prin date, nu prin bani.
Mai sunt doua costuri pe care oamenii le uita. Primul: cineva trebuie sa administreze serverul, sa faca update-uri si sa schimbe modelul cand apare unul mai bun. Al doilea: un AI public primeste imbunatatiri in fiecare luna fara sa faci nimic. Unul local se imbunatateste doar cand il imbunatatesti tu.
Cum arata arhitectura
Pe hartie e simplu. Utilizatorul deschide in browser o interfata de chat. Interfata trimite intrebarea la serverul de inferenta, care ruleaza modelul pe placa video. Cand intrebarea priveste documentele companiei, un al treilea strat cauta intai fragmentele relevante si le pune in fata modelului. Tehnica asta se numeste RAG (Retrieval Augmented Generation) si o explicam pe larg pe pagina Private AI & RAG.
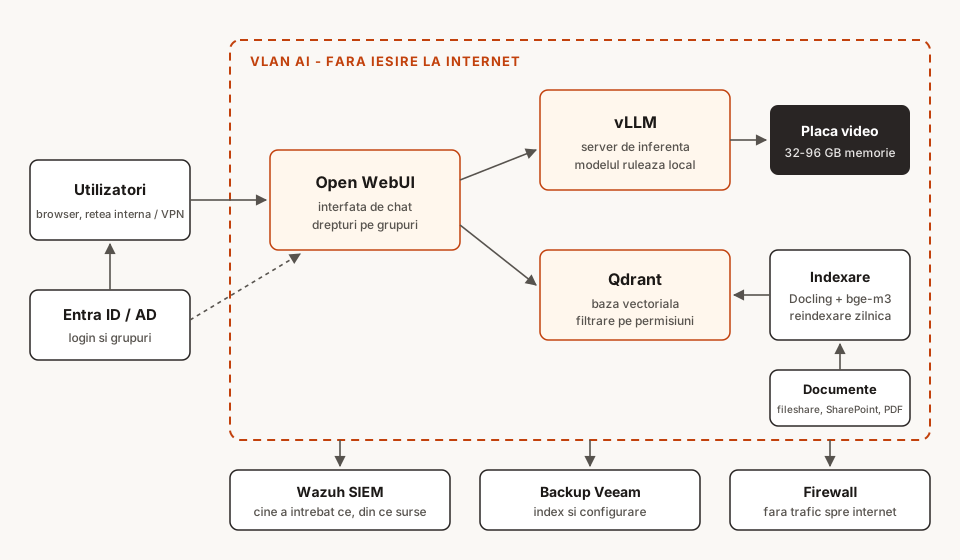
Componentele pe care le folosim in practica:
| Strat | Ce folosim | De ce |
|---|---|---|
| Sistem de operare | Ubuntu Server 24.04 LTS | suport lung, drivere NVIDIA stabile |
| Server de inferenta | vLLM (sau llama.cpp / Ollama pentru instalari mici) | vLLM tine bine multi utilizatori simultani |
| Interfata pentru utilizatori | Open WebUI | arata ca ChatGPT, are login prin Entra ID si drepturi pe grupuri |
| Baza vectoriala | Qdrant | rapida, se instaleaza local, filtreaza pe permisiuni |
| Citire documente | Docling | scoate textul si tabelele din PDF, Word si scanari |
| Embeddings | bge-m3 | intelege bine romana si engleza in acelasi index |
| Acces si criptare | reverse proxy cu TLS, certificat intern | nimic nu circula necriptat in retea |
Implementarea, pas cu pas
- Pregatesti hardware-ul si reteaua. Serverul intra intr-un VLAN separat. Firewall-ul lasa sa intre doar traficul de la utilizatori catre interfata web si nu lasa serverul sa iasa pe internet, cu exceptia update-urilor, pe care le deschizi cand le faci. Detalii despre segmentare gasesti pe pagina de networking enterprise.
- Instalezi sistemul si driverele. Ubuntu Server, driverul NVIDIA, CUDA si Docker cu suport pentru GPU. Verifici cu nvidia-smi ca placa e vazuta si ca temperatura e in regula sub sarcina.
- Pornesti serverul de inferenta. vLLM rulat in container, cu modelul ales descarcat o singura data. Modelul ramane pe disc, local. Din acel moment serverul poate functiona fara internet.
- Pui interfata si login-ul. Open WebUI se leaga la Microsoft Entra ID prin OpenID Connect si preia grupurile din token, deci drepturile se gestioneaza tot din Active Directory / Entra, nu dintr-o lista separata (documentatia Open WebUI). Cine pleaca din companie si e dezactivat in AD pierde automat accesul la AI.
- Conectezi documentele. Alegi sursele: un share cu proceduri, arhiva de contracte, documentatia tehnica. Le treci prin Docling, le imparti in fragmente, generezi embeddings cu bge-m3 si le pui in Qdrant. Fiecare fragment pastreaza eticheta grupului care are voie sa-l vada.
- Testezi cu intrebari reale. Strangi 50-100 de intrebari de la oamenii care vor folosi sistemul si verifici raspunsurile si sursele citate. Daca modelul greseste des, schimbi modelul sau felul in care sunt impartite documentele, inainte sa-l dai la toata lumea.
- Pornesti cu un departament. Un pilot de cateva saptamani arata repede ce merge si ce nu. Apoi extinzi.

Cum hranesti AI-ul cu datele companiei
Aici e cea mai mare confuzie. Nu "antrenezi" modelul pe documentele voastre. Antrenarea costa mult, dureaza si, odata facuta, nu mai poti scoate un document din model. Cu RAG, modelul ramane neschimbat, iar documentele stau intr-un index separat. Adaugi un contract nou, intra in index in cateva minute. Stergi un document, dispare si din raspunsuri.
Cateva lucruri de stiut de la inceput:
- Calitatea raspunsurilor depinde de calitatea documentelor. Un PDF scanat stramb, fara text, nu ajuta pe nimeni pana nu trece prin OCR.
- Versiunile vechi incurca modelul. Daca aveti trei versiuni ale aceleiasi proceduri, curatati intai arhiva.
- Cere intotdeauna sursa. Un raspuns care spune "conform procedurii PR-07, pagina 3" se poate verifica. Unul fara sursa, nu.
- Reindexarea trebuie programata. Zilnic sau la cateva ore, ca documentele noi sa intre singure.
Securitatea datelor
Faptul ca serverul e in companie nu il face automat sigur. Il face controlabil. Restul depinde de configurare.
Drepturile de acces trebuie sa urmeze drepturile din fisiere. Daca un angajat de la vanzari nu poate deschide dosarele de salarii pe fileserver, nu trebuie sa le poata citi nici prin chat. Asta se rezolva cu filtrarea pe grupuri in baza vectoriala, nu cu o regula in prompt.
Atentie la promptul injectat. OWASP pune manipularea prin prompt pe primul loc in riscurile aplicatiilor cu modele de limbaj, iar scurgerea de informatii sensibile pe locul doi (OWASP Top 10 pentru LLM 2025). In practica, un document cu instructiuni ascunse poate incerca sa convinga modelul sa ignore regulile. De aceea modelul nu primeste drepturi de a executa actiuni in alte sisteme fara aprobare umana.
Logurile merg in SIEM. Cine a intrebat ce si ce surse au fost folosite se pastreaza centralizat, de exemplu in Wazuh. Pentru o entitate NIS2, asta e diferenta dintre "credem ca e in regula" si "putem dovedi". Mai multe despre cerinte pe pagina de conformitate NIS2.
Backup pentru index si configurare. Modelul il poti descarca din nou oricand. Indexul construit din documentele voastre si setarile de acces, nu. Le pui in backup ca pe orice alt server (backup Veeam).
Datele personale raman date personale. Chiar daca nu pleaca din companie, prelucrarea lor printr-un AI intra sub GDPR: scop clar, acces limitat, retentie definita.

Ce castiga oamenii din companie
Partea vizibila e viteza. Un jurist gaseste clauza de penalitati din 40 de contracte in doua minute, nu intr-o dupa-amiaza. Un inginer de service intreaba "ce cuplu de strangere are flansa la modelul X" si primeste raspunsul cu pagina din manual. Cineva nou in companie intreaba cum se face un decont si primeste procedura, nu un coleg intrerupt de la treaba.
Partea mai putin vizibila e linistea. Oamenii folosesc deja AI, cu sau fara voia voastra. Daca le dai unul intern, rapid si legat de documentele lor, nu mai au motiv sa copieze contracte intr-un chatbot gratuit.
Accesul e simplu: o adresa interna in browser, login cu contul de serviciu, fara instalari pe calculatoare. Merge si de acasa, prin VPN-ul companiei.
Pe scurt, ce iti trebuie
| Element | Varianta minima | Varianta pentru 50+ utilizatori |
|---|---|---|
| Placa video | RTX 5090, 32 GB | RTX PRO 6000 Blackwell, 96 GB |
| Model | 8-32 miliarde parametri (ex. Qwen3) | gpt-oss-120b sau echivalent |
| Server de inferenta | Ollama sau llama.cpp | vLLM |
| Interfata | Open WebUI | Open WebUI cu Entra ID si grupuri |
| Documente | un share, indexat manual | mai multe surse, reindexare automata |
| Securitate | VLAN separat, fara internet | plus SIEM, backup, politica de utilizare AI |
Daca vrei sa vezi cum ar arata la tine, cu documentele si numarul tau de utilizatori, scrie-ne. Facem dimensionarea pe cazul real, nu pe tabelul de mai sus.
Un detaliu care surprinde pe toata lumea la primul pilot: serverul sta cea mai mare parte a zilei aproape la ralanti. Oamenii pun o intrebare, primesc raspunsul in cateva secunde si se intorc la treaba lor. Placa de 600 W munceste cateva minute pe ora si in rest consuma cat un frigider.
Intrebari frecvente
Pot rula un AI local fara placa video?
Tehnic da, pe procesor, cu modele mici. Practic, raspunsurile vin atat de incet incat oamenii renunta dupa o zi. Pentru uz zilnic intr-o companie ai nevoie de placa video sau de un sistem cu memorie unificata, de tipul DGX Spark.
Modelele locale inteleg romana?
Modelele mari actuale, precum Qwen3 sau gpt-oss, se descurca bine cu romana, inclusiv cu termeni tehnici si juridici. Modelele foarte mici, sub 7-8 miliarde de parametri, gresesc mai des. De aceea testam cu intrebari reale in romana inainte de productie.
Datele chiar nu ies din companie?
Nu, daca serverul e configurat corect: modelul ruleaza local, iar firewall-ul nu lasa serverul sa iasa pe internet. Verificarea se face simplu, din logurile firewall-ului.
Cat dureaza implementarea?
Depinde de cate surse de documente conectati si de cat de ordonate sunt. Partea tehnica de baza merge repede. Curatarea documentelor si testele cu oamenii dureaza mai mult. Termenul il stabilim dupa ce vedem documentele.
Pot folosi in paralel si Microsoft 365 Copilot?
Da, si multe companii fac asta: Copilot pentru e-mail si documentele obisnuite din Microsoft 365, AI-ul local pentru documentele care nu au voie sa plece. Detalii pe pagina de pregatire Microsoft 365 Copilot.